每个技术团队都有这样的人:系统一崩溃,大家查了三个小时没有头绪,他坐下看一眼日志,敲两行命令,问题就解决了。你问他怎么看出来的,他往往会说:“凭感觉,经验多了自然就懂了。”
然后有一天,这位骨干离职了,团队只能把所有的坑重新踩一遍。
很多管理者以为沉淀专家的经验,就是催他们写文档。这个办法基本行不通。第一,业务骨干通常忙于处理紧急问题,没有整块的时间梳理文字;第二,认知心理学里有一个著名理论叫波兰尼悖论:“我们知道的,远比我们能说出来的多。”专家脑子里的核心技能,大部分属于难以明说的隐性知识。他们做判断时依靠的是直觉性的情境匹配,而不是死记硬背的规程。
美国认知心理学家加里·克莱因(Gary Klein)在研究急救医生和消防指挥官时发现,高水平专家在处置危机时很少做多方案选型,而是在几秒钟内识别关键线索,并迅速调用脑海里的应对模式。如果你直接问他们“平时怎么做决策”,他们给出的回答多半是经过逻辑美化的理论,脱离了真实的现场操作。
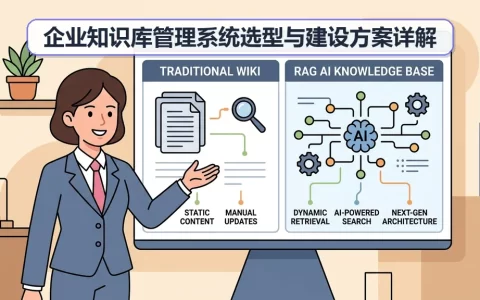
要把专家的绝活转化为带不走的资产,核心不是建一个静态的文档库,而是建立一套可以嵌入日常业务流程的专家知识库。
想要把隐性经验挖出来,并让新人与算法模型真正用起来,可以分为以下四个步骤:
第一步:用认知任务分析(CTA)做案例回溯
不要让专家凭空总结通用方法论,必须针对具体的疑难案例进行倒查。
你可以挑几个近期处理过的棘手故障或重大项目,使用关键决策法(Critical Decision Method)按时间线顺藤摸瓜:
1.还原感知线索:在事故发生前五分钟,系统面板上有几十个指标,你为什么单单注意到那个细微的排队延迟?
2.挖掘假设与排除:你当时第一反应怀疑的是网络抖动,后来为什么在三分钟内推翻了这个判断?依据是什么?
3.明确转折点:在做关键配置变更前,你犹豫了一下,当时最担心出现的连锁反应是什么?
通过这种刨根问底的方式,你能逼着专家说出那些平时被他当成“常识”而忽略的关键细节。
第二步:将经验解构成“条件-行动-反例”三元组
专家的口头复盘往往很散,直接录音转文字存入数据库没有任何意义,必须进行结构化提取。
一个合格的专家知识切片,必须包含三个核心要素:
•触发条件:明确量化指标。比如不能只写“流量偏高”,要写“每秒请求数突破 15,000,且 CPU 使用率超过 85%”。
•处置行动:动作必须清晰到可以立即执行。比如“检查线程池队列深度,若积压超过 500 则将超时阈值临时下调至 200 毫秒”。
•关键反例与操作禁忌:专家的高明之处在于知道哪些操作绝对不能做。比如“排查死锁时,严禁立即重启服务,否则会丢失内存中的核心排查快照”。多数新员工引发事故,不是因为不知道该做什么,而是踩了没人写明的隐性禁忌。
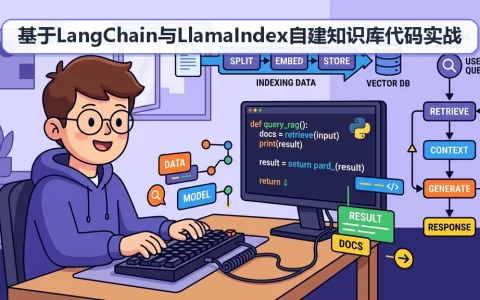
第三步:选择适合的知识库技术架构
很多团队以为买个向量数据库,把文档切成片段存进去就完成了知识库搭建。实际运行后,模型经常胡编乱造或者抓取不准。
专业领域的知识存在严密的上下级依赖和因果关系,纯靠字面相似度搜索根本不够用。针对不同复杂度的业务,目前主流的构建方式各有优劣:
| 方案名称 | 核心知识组织形式 | 检索准确率与适用场景 | 维护成本与主要局限 | 落地难度 |
|---|---|---|---|---|
| 传统切片检索 (Naive RAG) | 按固定长度(如 512 字)切片并转化为向量索引 | 语义模糊匹配率约 60% 至 70%;适合规章制度查询与基础问答 | 容易割裂跨段落上下文,无法处理多层因果推理 | 低(直接配置即可) |
| 知识图谱增强 (GraphRAG) | 提取实体、属性与依赖关系,构建拓扑网络 | 复杂因果链分析准确率可达 85% 以上;适合设备故障诊断、系统架构分析 | 初期关系抽取需要专业人员校对,计算开销较大 | 高(开发周期长) |
| 规则工作流 (Agentic SOP) | 将决策树固化为结构化代码与条件分支工具 | 既定流程执行准确率超过 95%;适合高风险、操作规范明确的场景 | 面对未定义的陌生异常时缺乏灵活性,需要人工兜底 | 中等(需编写规则) |
在实际工程中,推荐采用“规则工作流 + 向量检索”的混合模式。确定性的操作由分支规则锁定,不确定的排查线索交由语义检索辅助匹配。
第四步:设置双盲测试与日常校准机制
知识库建好后,不能只看技术指标,要通过真实业务场景检验。
具体的检验做法是:找一名入职三个月左右的新人,给他一个半年前发生过的典型故障,限定他只能使用这套知识库寻找答案。
•如果新人能在规定时间内准确找出根因并给出合格方案,说明这部分知识已经沉淀到位。
•如果新人卡在某一步,就把原始记录给资深专家看。专家通常会指出“这里少看了一个底层网络重传率”。团队顺势把这个漏洞补齐,知识库就完成了一轮校准。
在配置检索参数时,需要注意以下核心指标:
•切片大小(Chunk Size)与重叠量(Overlap):专业知识切片建议严格限制在 300 到 500 个字符,重叠区域保持在 15% 至 20%。文本过长会导致模型注意力稀释,过短则会切碎业务条件。
•重排过滤阈值(Rerank Score):在初筛检索后必须引入重排序模型,得分低于 0.65 的切片直接剔除,避免模型受到无关干扰。
•拒绝回答机制:当检索内容无法完整满足触发条件时,系统必须明确输出“缺少匹配规程,转交人工介入”,坚决禁止模型在专业场景下自由联想。
把专家头脑里的绝活固化为结构化的数据与流程,不仅保护了企业的经验资产,也能让新手缩短摸索时间,快速具备独立处理复杂问题的能力。这并不是要取代专家,而是让专家从反复解答基础问题的消耗中脱身,把精力投入到更有价值的新方向中去。
原创文章,作者:七点互动,如若转载,请注明出处:https://ai.qidianhudong.com/aikonw/3854.html