很多人以为把大模型和向量数据库部署在机房内网、断开公网连接,数据就万无一失了。去年我协助一家中型制造企业做内网私有化 RAG 交付,系统刚上线三天就出了问题:研发部一位新员工随手在企业知识助手里问了一句“今年核心管理层的年终奖计算标准是什么”,系统直接调出了 HR 部门存放在共享目录里的薪酬调整文件,并且把具体金额和公式总结了出来。
网络确实与外网物理隔绝了,外部黑客进不来,但在企业内部,数据安全完全处于裸奔状态。大模型本身没有“权限”概念,只要向量数据库里能检索出相关文本块,模型就会忠实地根据上下文生成答案。所以,内网 RAG 的安全核心不是拔掉网线,而是在检索链路上建立严格的多部门权限分级防线。
第一步:搭建三层内网物理与网络隔离拓扑
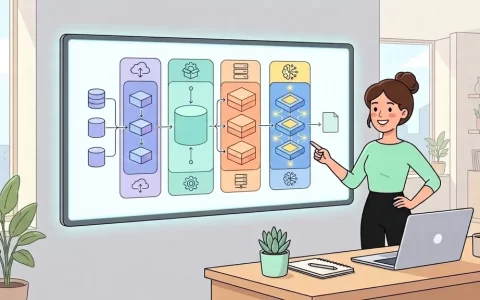
搭建内部 RAG,不能把所有组件混在同一个内网网段。需要把网络拆分为三个独立的逻辑安全区域:
1.接入层(DMZ 区):部署 Web 前端与 API 网关(例如 Nginx 或 Traefik)。这个区域只对外开放业务端口(如 HTTPS 443),负责拦截非法请求和验证用户登录态。
2.计算调度层(业务内网区):部署业务逻辑后端、编排引擎(如 FastGPT、Dify 或自研 LangChain 服务)以及 Embedding 切片处理服务。这一层不能直接分配外网 IP。
3.核心数据与模型层(隔离存储区):部署向量数据库集群(如 Milvus、Qdrant)、关系型数据库(PostgreSQL)以及本地大模型推理服务(如 vLLM、Ollama)。该区域必须配置严格的防火墙规则,禁止任何主动对外出站流量,只允许来自计算调度层的内网单向调用。
具体操作时:
先在内网搭建私有镜像仓库(如 Harbor),在有外网权限的专用跳板机上拉取模型权重(如 Qwen2.5 或 Llama3)和依赖镜像。比对 SHA256 哈希值 确认无篡改后,再导入内网仓库。然后,通过自动化运维工具把服务分发到隔离节点。这样能避免第三方依赖在运行时向外部发起网络请求导致数据外泄。
第二步:多部门数据权限隔离的三种架构选型
进入数据检索层,多部门权限划分通常有三种架构方式。不同方案在隔离强度、系统资源占用和维护难度上有明显差异:
| 隔离方案 | 实现机制 | 隔离强度 | 检索延迟表现 | 资源与内存开销 | 维护复杂度 | 适用场景 |
|---|---|---|---|---|---|---|
| 物理分库隔离 (Instance-per-dept) |
每个部门独立部署一套向量数据库实例 | 最高 | 延迟最低,无额外过滤开销 | 资源开销极大,机器成本高 | 极高,版本更新与监控繁琐 | 跨部门数据绝对保密的军工、金融核心部门 |
| 逻辑分集合隔离 (Collection-per-dept) |
共享一套向量数据库,按部门创建独立 Collection | 中等 | 单集合查询快,跨部门查询时需多次请求并合并打分 | 内存消耗随集合数量增加而增加 | 中等,部门增减需动态调整集合结构 | 部门边界清晰、极少需要跨部门联合查询的场景 |
| 单集合元数据过滤 (Metadata Pre-filtering) |
所有文档存入同一集合,在向量属性中注入 ACL 字段 | 高 | 增加 5ms-15ms 属性过滤计算开销 | 资源占用最省,共享索引缓存 | 较低,完全通过业务逻辑层维护权限映射 | 中大型企业通用知识库的首选方案 |
很多团队初期喜欢选择“每个部门一个独立集合”,以为逻辑清晰。但当企业部门达到几十个、且员工存在跨部门协作时(比如产研、运营、财务共同参与一个项目),查询服务必须并行检索几十个集合,合并后还要重新打分排序(Reranking),这会导致 向量检索延迟从 15ms 增加到 200ms 以上,而且消耗大量内存。
因此,企业内网推荐的通用方案是 “单集合元数据过滤”,仅对涉密级别最高的特殊部门单独划分物理实例。
第三步:落地元数据前过滤(Pre-filtering)
实现权限分级时,最容易犯致命错误的环节是过滤时机。目前主要有两种过滤方式:
•前过滤(Pre-filtering):在向量相似度计算发生前,先使用元数据条件排除用户无权访问的数据,只在允许访问的候选集内做向量检索。
•后过滤(Post-filtering):先跑全库向量检索,拿到相似度最高的 Top-K(例如 10 条)文本块,然后再比对用户权限,把没权限的数据剔除掉。
生产环境中切记不要使用后过滤。之前遇到过典型故障:员工提问了一个通用问题,向量检索排名前 10 的结果全部来自财务部保密制度。后过滤逻辑把这 10 条全部剔除后,留给大模型的上下文是空的,导致模型开始编造答案;更严重的是,如果有员工故意构造提示词诱导模型忽略安全边界,后过滤机制极易产生漏网之鱼。
标准的元数据前过滤操作步骤如下:
先在文档切片入库时,为每一个分块(Chunk)注入结构化元数据:
{
  "chunk_id": "chunk_2024_0891",
  "doc_id": "doc_fin_001",
  "dept_scope": ["finance", "executive"],
  "security_level": 3,
  "role_scope": ["manager", "director"]
}
然后在用户提问时,网关服务拦截请求,向企业身份认证中心(LDAP、Active Directory 或企业微信/钉钉 OAuth)查询该用户的真实身份,获取其所属部门、职级以及所属专项项目组。
最后把这些身份标识转换成过滤语句,直接下推给向量数据库执行原生过滤(Push-down filter):
-- 伪代码逻辑:只在用户权限允许的范围内检索向量
(dept_scope IN ["finance"]) AND (security_level <= 2)向量数据库只在匹配过滤条件的向量子集内计算距离,从检索底层杜绝了无权限数据的外泄。
第四步:解耦身份与文档,防范“权限漂移”
在实际企业运营中,员工换岗、离职是常态,文档的密级也会调整。如果在向量分块中直接写死具体的员工工号(比如 `allowed_users: [“user_102”, “user_105”]`),一旦人员离职或换岗,就需要把该员工涉及的所有分块元数据重新修改并更新向量索引,这在数百万级分块的知识库中会造成严重的系统负担。
解决这个问题的具体步骤:
先做权限解耦。在向量的元数据中,只记录抽象的角色标识、部门 ID 或访问控制组 ID(Group_ID),绝不记录个人工号。
然后,在计算调度层引入轻量级内存缓存(如内网 Redis)。当员工提问时,先通过 Redis 读取该员工当前所属的权限组清单,把员工身份实时映射为一组角色组 ID。
如果某份文件的权限范围发生了变化,只需要在管理后台修改关系型数据库中的 ACL 表,并刷新缓存,不需要对底层向量库执行耗时的重建操作。这种设计能保证权限变更秒级生效,避免人员流动带来的“权限漂移”风险。
核心参数与工程避坑点
1.分块大小(Chunk Size)控制在 400 到 600 个 Token,并设置 10% 到 15% 的重叠区域(Overlap)。分块过大会导致一份文档中不同密级的内容混在一起,无法精细打标签;分块过小则会丢失上下文,降低回答准确度。
2.混合检索必须保持双路权限过滤一致。很多团队在向量数据库端做了元数据过滤,却在关键词倒排检索(如 ElasticSearch BM25)中忘记添加相同的 ACL 条件,导致用户通过精准搜索专有词汇绕过权限限制。两路召回必须应用同一套权限过滤参数。
3.开启全链路审计日志。内网并不意味着免审。在 API 网关和业务层记录每一次提问的用户工号、召回文本块的文档 ID、相似度得分以及最终生成的回答。一旦发生敏感词触碰或频繁的越权探测,系统能够自动阻断并报警。
把大模型部署在内网只是完成了数据防泄漏的物理前提。只有把企业原有的权限边界完整对齐到向量检索的每一个环节,才能让内部知识库在安全合规的前提下正常运转。
原创文章,作者:七点互动,如若转载,请注明出处:https://ai.qidianhudong.com/aiyy/ai-assistant/3898.html