很多朋友经常问我:想搭一个能查自己私人笔记、公司内部资料的本地知识库,是不是必须花上万元买带大显存的显卡?
答案完全是否定的。你甚至一分钱都不用多花,手头一台现成的 16GB 内存笔记本就能直接跑起来。
我自己最早在测试这套方案时,用的就是一台几年前买的普通轻薄本(没有独立显卡,只有 16GB 内存)。跑一个参数较小的文本模型加上嵌入模型,整个流程完全能在本地顺畅运行。之所以要做本地化,核心原因就是数据隐私与零调用成本:你不需要把商业合同、财务报表或者个人日记传到第三方云端,所有文档切片、向量存储与问答推理,全部都在本地磁盘和内存里闭环。
下面我把整个搭建过程拆成清晰的 3 步,照着做就能跑通属于你自己的本地知识库。
第一步:按需选型,把硬件与模型成本压到最低
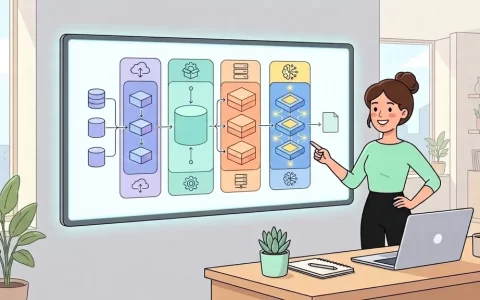
搭建本地知识库(行业里叫 RAG,即检索增强生成),你需要两个模型分工合作:
1.Embedding 模型(文本嵌入模型):负责把你上传的 Word、PDF 或 Markdown 切成小段,转换成计算机能理解的数学向量。
2.LLM(大语言模型):负责看懂你的问题,结合检索出来的文档片段,整理出一份条理清晰的回答。
很多人一开始就踩坑,以为模型越大越好,盲目下载几十 GB 的大模型,结果机器内存直接爆掉,电脑卡死。根据我长期的实测测试,在 16GB 内存无独显的环境下,7B 或 8B 参数、经过 4-bit 量化(Q4_K_M)的模型性价比最高。
针对不同需求,我整理了一份主流开源方案的对比选型表供你参考:
| 选型方案 | 部署难度 | 硬件门槛 | 适用场景 | 优势与局限 |
|---|---|---|---|---|
| AnythingLLM + Ollama | 简单(桌面安装包) | 8GB 内存起步(无独显可用) | 个人文档阅读、本地日记检索 | 优势:单机点开即用,内置向量数据库; 局限:多用户协作支持较弱。 |
| Dify (Docker) + Ollama | 中等(需 Docker 基础) | 16GB 内存 + 4GB 显存推荐 | 个人复杂工作流、团队内部系统 | 优势:支持复杂 Prompt 编排与多模型切换; 局限:后台容器多,冷启动占用约 3GB 内存。 |
| MaxKB / RAGFlow + Ollama | 中等 | 16GB 内存推荐 | 含有复杂表格、长 PDF 的专业场景 | 优势:文档版面还原度高,表格解析精准; 局限:轻量级设备上解析大文件耗时较长。 |
如果你追求最快见效、不想折腾复杂的命令行,优先选择 AnythingLLM;如果你平时喜欢自定义工作流,或者想跟团队成员共享知识库,选 Dify。
第二步:安装运行底座,下载两套关键模型
选好方案后,先做 A(安装底座),然后做 B(拉取模型),这样能帮你更快完成本地环境验证。
1.安装本地运行底座 Ollama
进入 Ollama 官网下载对应系统的安装包(Windows、macOS、Linux 均支持)。安装完成后打开终端(Terminal 或 PowerShell),输入 `ollama -v`,看到版本号就说明装好了。
2.拉取大语言模型
在终端直接运行这行命令:
ollama run qwen2.5:7b为什么推荐通义千问 Qwen2.5?因为在中文知识问答和上下文逻辑理解上,它的实际表现非常稳定,7B 版本的显存占用只有 4.7GB 左右,CPU 单靠内存推理也能达到每秒 8 到 12 个字的速度,完全满足阅读要求。
3.拉取嵌入向量模型
终端继续执行:
ollama pull bge-m3千万不要忽略这一步。很多人直接拿默认的英文嵌入模型处理中文,搜出来的结果往往风马牛不相及。由北京智源研究院开源的 bge-m3 是目前本地中文检索里公认极度扎实的模型,支持多语言、长文本切片,内存占用仅需 1.2GB 左右。
第三步:配置知识库界面,避开文档检索的关键坑
有了底座与模型,最后一步就是挂接知识库前端并导入文档。这里以最轻量易上手的 AnythingLLM 为例,它自带单机向量数据库(LanceDB),免去了配置独立数据库的麻烦。
先去 AnythingLLM 官网下载安装包,启动后按照向导做三处关键配置:
1.LLM Provider:选择 `Ollama`,URL 保持默认的 `http://127.0.0.1:11434`,模型选择刚才下载的 `qwen2.5:7b`。
2.Embedding Engine:选择 `Ollama`,模型选择 `bge-m3`。
3.Vector Database:选择系统自带的 `LanceDB`(本地轻量存储,不需要额外配置)。
把你的本地技术文档、会议纪要或个人笔记直接拖入工作区,点击构建向量索引。但在正式提问之前,请务必根据自己的实际文本调整以下两个核心参数,否则知识库很容易出现“答非所问”或者“胡说八道”的情况:
•文档分块大小(Chunk Size)建议设为 400 – 600 字符:很多初学者直接按默认的 1000 字符甚至更大去切分。文本块切得太大,会带入大量不相干的背景噪音,导致模型抓不住重点;切得太小(比如低于 100 字符),句子会被切断,丢失主谓宾上下文。
•重叠长度(Chunk Overlap)设为 10% – 15%(即 50 字符左右):这样切分时能保留相邻段落的承接关系,防止关键结论正好被切在一分为二的边界处。
•匹配数量(Top-K)设为 3 到 4:这意味着每次提问,系统只捞出最匹配的 3 到 4 段文字给大模型阅读。如果设得太大(比如 10 段),本地小模型处理超长上下文的注意力会分散,回答质量反而会大幅下降。
操作避坑提示:
如果你使用的是 Docker 部署的 Dify,连接本地 Ollama 时填 `http://localhost:11434` 会报错。因为 Docker 容器内的 localhost 指向的是容器自己,而不是你的电脑。在 Windows 和 Mac 下需要将地址改为 `http://host.docker.internal:11434`;如果是 Linux 系统,需要改为宿主机的网桥 IP(通常是 `http://172.17.0.1:11434`),同时确认 Ollama 开启了跨域与远程监听。
配置完成后,尝试向它提问一个文档里包含的冷门细节。你会发现它在几秒钟内就能精准找出原文段落,并根据你的要求总结输出,整个过程完全断网也能正常运转。
原创文章,作者:七点互动,如若转载,请注明出处:https://ai.qidianhudong.com/aikonw/4324.html