上周我和一位在中型电商做运营负责人的朋友聊天,他跟我倒了一晚上苦水。他们运营团队花了两周策划大促满减规则,结果上线第一天,客服部门被客户投诉刷爆了——因为客服根本不知道优惠券不能叠加跨店满减,客服知识库里存的还是三个月前的旧版退换货政策。与此同时,仓储物流部门因为没提前拿到大促预售的备货清单,导致发货时效严重超标。
大家都在加班,甚至大家都在同一个几百人的协同大群里,但事情依然做成了一团糟。
很多人以为跨部门协作差是因为员工态度有问题,或者沟通不够积极。其实根本不是。跨部门流程断层的本质,是信息在部门边界处发生了丢包与滞后。Gartner 在一项关于职场协作的调研中指出,84% 的业务管理者和员工在跨部门工作中感受到了严重的“协作阻力”;而麦肯锡的统计数据也显示,知识型员工每周平均要耗费 9.3 个小时仅仅用来查找工作所需的信息。
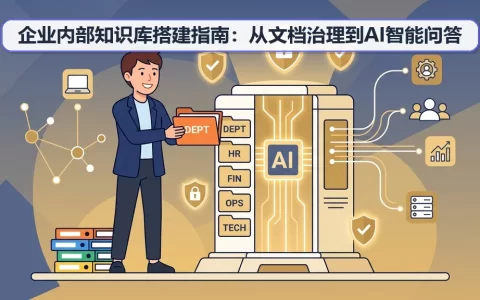
如果每个部门都有自己的信息小黑盒,开再多拉齐会也解决不了问题。要解决协同内耗,最直接、成本最低的抓手,就是重构面向业务流的知识库。
很多公司内部其实早就有知识库,不管是放了几百个 Word 文档的内部网盘,还是买了几年却没人看的协同文档。这些系统之所以沦为“僵尸知识库”,主要踩了三个雷:
第一,按行政组织架构建文件夹,而不是按业务流转链路建索引。打开知识库,一级目录是“市场部”、“销售部”、“产研部”、“客服部”。当销售需要向客户确认一个交付细节时,他根本不知道该去产研部门的哪个文档里找,最后只能发微信直接问人。
第二,缺乏明确的内容所有者(Document Owner),文档无人维护。文档写完那天就是它准确率最高的一天。业务规则变了,代码改了,没有人负责更新文档。下次别人照着旧文档执行,出了问题又变成部门之间的互相推诿。
第三,工具割裂且缺乏权限分级标准。技术团队用 GitLab Wiki,运营用本地 Excel,HR 用钉钉文档。工具之间彼此不通,文档散落在不同的角落,跨部门找资料就像在多个迷宫里乱撞。
要让业务知识库真正跑起来,消除流程断层,可以按照以下四个步骤来做。
第一步:梳理跨部门业务交接面,把“行政目录”改为“场景目录”
先做业务流程的梳理,找出跨部门流转的交接点,然后基于交接场景建立知识目录。
不要让各部门把内部的工作草稿堆在公开知识库里。先找出高频发生扯皮、询问频率最高的业务交接面。例如“新功能上线到销售推广”、“客诉升级到研发排查”、“合同审批到财务打款”。针对这些交接场景建立独立的协作工作区。关键在于目录命名必须以业务事件为导向,而非以部门职能为导向。
第二步:建立单一事实来源(SSOT)与文档责任人制度
先确定每一项核心业务规则只有一份基准文档,然后明确指定文档维护人(Owner)。
在很多企业里,同一个退款规则,运营手上有一份,财务手上有一份,客服手上还有一份,三份内容对不上。必须推行单一事实来源原则(Single Source of Truth)。一项业务规则只允许存在一个主文档,其他部门只能引用该链接,禁止私自另存为副本。
同时,文档首页必须强制标明三个要素:
1.责任人(Owner):谁负责维护此文档的真实性。
2.适用版本与更新日期:最后一次校验业务逻辑的时间。
3.变更审核人:规则调整需要哪些跨部门节点确认。
第三步:把知识更新嵌进审批与交付流程,做变更触发机制
先制定触发条件,然后在工作流结束前完成文档更新验收。
文档写了没人更新,是因为更新文档游离在员工的考核与业务交付之外。解决办法很简单:把知识沉淀变成流程通行的前置条件。例如,研发发布新版本时,代码合并的 Checklist 里面必须包含“对外接口变更说明与文档链接”;运营调整价格策略时,OA 审批流通过后,自动触发对客服主管的文档同步提醒。只要更新动作不进入日常流程,静态的知识库就一定会失效。
第四步:合理选择协作工具并进行权限规划
选择工具时,不需要追求功能最花哨的系统,核心看它是否符合团队的沟通习惯和数据安全要求。以下是目前主流的知识库选型方案对比:
| 工具名称 | 部署模式 | 权限控制粒度 | 跨系统集成能力 | 学习上手成本 | 适用团队规模 |
|---|---|---|---|---|---|
| Confluence | 本地私有化 / 海外云端 | 页面级与空间级精细控制 | 与 Jira、GitLab 等研发工具深度集成 | 较高,需要专人管理配置 | 500人以上成熟产研与跨国团队 |
| 飞书知识库 | 公有云 / 专属云 | 文档级、文件夹级及角色组控制 | 与即时通讯、审批流、多维表格天然打通 | 低,界面直观易用 | 20人至万人规模的敏捷业务团队 |
| Notion | 海外公有云 | 页面级与团队空间控制 | API 开放度高,数据库联动灵活 | 中等,自由度高但规范难度大 | 100人以下扁平化初创团队 |
| Dify + 本地向量库 | 完全私有化部署 | 依赖底层系统或独立账号体系控制 | 支持知识检索接口对接企业微信/钉钉 | 高,需要技术人员维护模型与算力 | 对数据私密性有硬性要求的中大型企业 |
根据表格可以看到,如果你是研发主导、流程极其规范的团队,Confluence 的结构化和版本控制能力更稳;如果你更看重即时沟通和流程打通,飞书知识库能让文档直接在聊天群和审批里流转;如果你对数据出境有严格合规限制,或者想让员工直接通过自然语言问答查找规章,使用 Dify 搭建私有化检索库是更合适的路径。
落地过程中,有两个极易翻车的避坑点需要注意:
•避坑提示一:切忌给全员开放根目录创建权限。一旦放开权限,知识库在两个月内就会变成垃圾场,充斥着“未命名文档”、“新建文件夹(2)”。一级和二级目录必须收紧管理,由业务负责人共同讨论后锁定,员工只能在对应业务场景的三级目录下补充内容。
•避坑提示二:切忌盲目追求大而全的全量搬迁。很多团队刚开始做知识库时雄心勃勃,要求全员停下业务整理过去三年的历史文件,结果耗时一个月,产出大量无效文档,团队怨声载道。正确的做法是“老账从简,新账从严”,先挑一个摩擦最多的业务交接点(比如产研到客户支持)做试点,把这一个链路跑顺,大家尝到信息透明的甜头后,再逐步向其他流程推广。
核心结论:业务知识库不是资料档案室,而是跨部门协同的运转说明书。衡量一个知识库好坏的标准,从来不是里面存了多少万字的内容,而是当业务发生变动时,下一个环节的人能不能不用打电话、不开发票起冲突,就能直接按照文档标准把事情准确做完。把信息孤岛打破,把交接规范写清,跨部门的内耗自然就会大幅减少。
原创文章,作者:七点互动,如若转载,请注明出处:https://ai.qidianhudong.com/aikonw/4362.html